在瀏覽器輸入你的網址,後面加上 /robots.txt,找 GPTBot、ClaudeBot、PerplexityBot、Google-Extended 這四個跟 AI 爬蟲有關的名字。四個都沒出現,寫給所有爬蟲的那一段也沒有 Disallow: /,代表這四個名字在 robots.txt 裡沒有被你擋掉;同一家公司的其他名字,例如 OAI-SearchBot、Claude-SearchBot,也要一起找,主機或 CDN 的防火牆另外要看。要不要擋,先想清楚你在意的是內容被拿去訓練模型,還是在 AI 的回答裡被找到,各家用不同的名字管這些事。擋不擋 Google-Extended,都不影響你在 Google 搜尋的收錄和排名,但會影響 Gemini Apps 和 Vertex AI 回答時能不能拿你的內容參考;llms.txt 對 Google 搜尋也沒有加分或扣分,要不要做,看你在不在意其他 AI 服務。
打開 robots.txt,先找這四個名字
robots.txt 是放在網站根目錄的純文字檔,寫給自動抓網頁的程式看,告訴它們哪些路徑可以抓、哪些不行。每一段從 User-agent 開始,後面接爬蟲的名字,下面幾行寫 Allow 或 Disallow。名字寫成星號的那一段,套用到所有沒被另外點名的爬蟲。
拿 QDM Blog 自己當例子。2026 年 10 月 10 日打開 blog.qdm.tw/robots.txt,前三行是這樣:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
最後再一行 Sitemap,告訴爬蟲網站地圖在哪。意思是所有爬蟲都別進後台,其他頁面都可以抓。整份檔案裡沒有任何 AI 爬蟲的名字,這是我們自己選的:部落格寫的是給店家參考的做法,被 AI 搜尋讀到、引用,對我們是好事。
讀自己的 robots.txt 時,除了找那四個名字,也要看星號那一段有沒有 Disallow: /。有的話,等於連 AI 爬蟲一起擋掉,就算你從來沒寫過 GPTBot 也一樣。
每個 AI 爬蟲的名字各管什麼?
各管的事不一樣:GPTBot、ClaudeBot 跟訓練有關,OAI-SearchBot、Claude-SearchBot、PerplexityBot 管搜尋,Google-Extended 同時管訓練和 Gemini Apps 的參考。
標題說的四個名字,分屬 OpenAI、Anthropic、Perplexity 和 Google,各家分法不一樣。OpenAI 和 Anthropic 把訓練用和搜尋用分成不同名字;Perplexity 官方寫明 PerplexityBot 不拿來訓練;Google-Extended 則是一個名字同時管訓練和 grounding。下表整理自各家官方說明,2026 年 10 月 10 日讀取:
| 名字 | 公司 | 官方寫的用途 | 擋掉代表什麼 |
|---|---|---|---|
| GPTBot | OpenAI | 抓取可能拿來訓練生成式 AI 基礎模型的內容 | 表示你的內容不要拿去訓練 |
| OAI-SearchBot | OpenAI | 讓網站出現在 ChatGPT 搜尋功能的結果裡 | 不會出現在 ChatGPT 搜尋的回答裡,但仍可能以導覽連結出現 |
| ClaudeBot | Anthropic | 收集可能用於模型訓練的網頁內容 | 表示你之後的內容不要拿去訓練 |
| Claude-SearchBot | Anthropic | 瀏覽網頁來改善搜尋結果的品質 | 內容不會被拿去做搜尋索引,在搜尋結果裡被找到的機會可能變少 |
| PerplexityBot | Perplexity | 讓網站出現在 Perplexity 的搜尋結果並附上連結,官方寫明不拿來抓 AI 基礎模型的訓練內容 | 官方建議想出現在搜尋結果就放行它 |
| Google-Extended | 管理 Google 抓到的內容,能不能用來訓練未來的 Gemini 模型(用在 Gemini Apps 和 Vertex AI API for Gemini),以及能不能在 Gemini Apps 和 Vertex AI 的 Grounding with Google Search 裡做 grounding,也就是回答時把 Google 搜尋索引裡的內容交給模型參考 | 不影響網站被收錄進 Google 搜尋,也不是 Google 搜尋的排名訊號 |
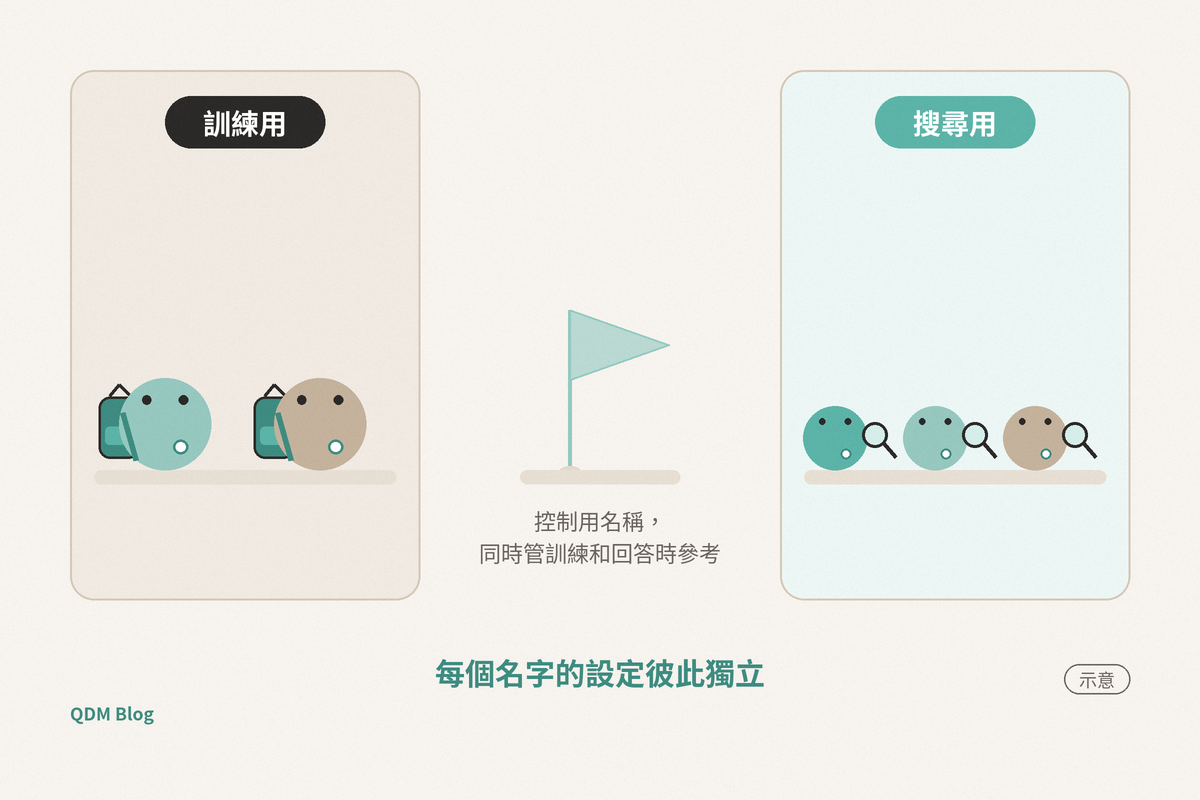
Google-Extended 跟其他幾個不一樣。Google 官方寫明它沒有自己的 HTTP user agent,抓取時用的是 Google 既有的爬蟲,Google-Extended 只是寫在 robots.txt 裡做控制用的名稱。所以你在伺服器紀錄裡看不到它,想知道自己有沒有擋,只能看 robots.txt 裡有沒有寫它。
表上沒有列的,還有使用者自己觸發的抓取:有人在 ChatGPT、Claude 或 Perplexity 提問,系統當下去開某個網頁。OpenAI 說 ChatGPT-User 是使用者發起的,robots.txt 規則可能不適用;Perplexity 說 Perplexity-User 大致會忽略 robots.txt;Anthropic 則說在 robots.txt 停用 Claude-User,系統就不會為了回答使用者而去讀你的內容。
要擋哪一個?
搜尋用的建議留著;擋 Google-Extended 是表示不希望內容用於訓練 Gemini,或供 Gemini Apps 和 Vertex AI 參考,不影響 Google 搜尋。
OpenAI 和 Perplexity 的文件都寫明,每個名字的設定彼此獨立。所以你可以擋訓練用的名字、留著搜尋用的,例如在 robots.txt 加上這三段。最後一段的 Google-Extended 要看清楚:擋了不只管訓練,Gemini Apps 和 Vertex AI 回答時也不能拿你的內容做 grounding。
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /
要怎麼選,各家文件沒有替你決定,下面是我的建議。開店是希望顧客問 AI「哪裡買得到」的時候能找到你,搜尋用的那幾個(OAI-SearchBot、Claude-SearchBot、PerplexityBot)我會留著;訓練用的 GPTBot、ClaudeBot,就看你對內容被拿去訓練模型的接受度。Google-Extended 要另外想:擋了不影響 Google 搜尋,是表示不希望內容被 Gemini Apps 和 Vertex AI 回答時拿去參考;在意 Gemini Apps 回答時能參考你的內容,我會留著。像 QDM Blog 這種本來就想被引用的內容網站,全部放行也說得通。
Anthropic 另外提醒,每個子網域都要各自設定。如果你的商店和部落格分在不同子網域,兩邊的 robots.txt 都要改。
如果你的店開在 QDM 開店平台,後台有自訂 robots.txt 的功能,你加的規則會接在平台固定的規則後面;固定的那幾行會擋後台和系統必要目錄、帶入網站地圖,讓自訂內容不會影響網站正常運作。功能說明在服務中心〈2026.7.28 新增自訂 robots.txt〉。
確認伺服器沒有另外擋
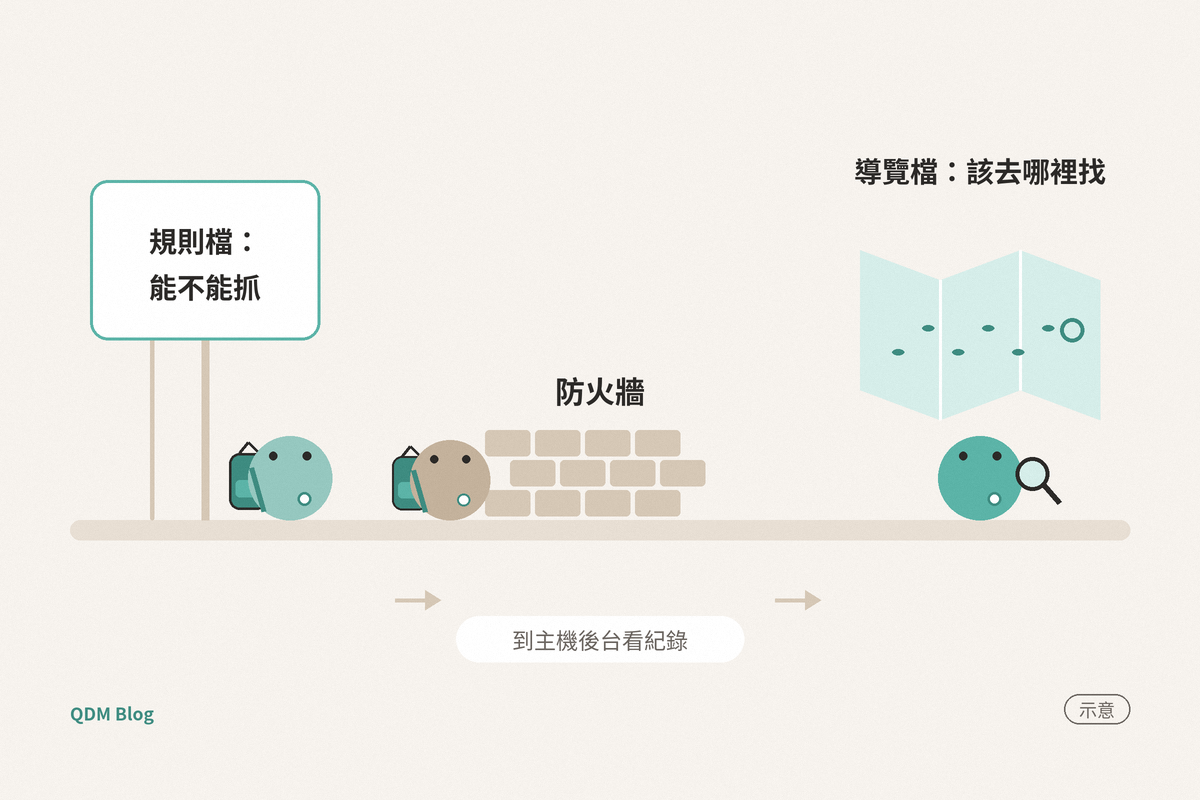
robots.txt 是寫給爬蟲看的規矩。如果主機或 CDN 的防火牆設了阻擋規則,就算 robots.txt 允許,爬蟲也進不來。OpenAI 在搜尋用的 OAI-SearchBot 那一段,建議放行它公布的 IP 範圍;Perplexity 也建議放行公布的 IP 範圍,文件還寫了防火牆的放行設定方式。
我們 10 月 9 日晚上用 GPTBot、ClaudeBot、PerplexityBot、OAI-SearchBot、Googlebot 五種 user agent 字串,去抓部落格的一篇文章,五次都回 200,也就是正常讀到頁面。這五個跟前面的四個名字不同,是因為 Google-Extended 沒有自己的 user agent 可以測,所以換成搜尋用的 OAI-SearchBot 和 Google 搜尋的 Googlebot。用 user agent 字串測,只看得出伺服器沒有依 user agent 擋人;真的爬蟲從各家公布的 IP 過來時會不會被攔,你可以到 CDN 或主機的後台看紀錄。
如果你也在評估 ChatGPT 的廣告,廣告審核用的是另一個爬蟲 OAI-AdsBot,到達頁要注意的地方我們在〈ChatGPT 廣告,台灣電商要不要立刻開始〉整理過。
看情況再做 llms.txt
llms.txt 是 Jeremy Howard 在 2024 年 9 月提出的格式提案,2026 年 8 月更新到第二版。做法是在網站根目錄(也可以是某個子路徑)放一個 Markdown 檔:依序以網站名稱的大標開頭,這是唯一必填的部分,再接一段引言格式的摘要,再用幾個小標題列出連結,每個連結可以附一句說明。提案寫的用途,是讓 AI 助理在幫使用者回答問題時,先讀這份檔案,再照著連結去找需要的內容。它和 robots.txt 管的事不一樣,robots.txt 講能不能抓,llms.txt 講該去哪裡找。
Google 的說法很直接:Google 搜尋不使用 llms.txt,做了不會幫助、也不會傷害你在 Google 搜尋的能見度和排名;如果是為了其他會用到它的服務而做,完全沒問題。
對開店的人,我會把 llms.txt 排在 robots.txt 和防火牆之後。提案裡提到,企業可以用它整理公司的架構和政策;放到網路商店,我會挑顧客比較可能問 AI 的幾頁放進去,例如品牌介紹、運送和退換貨說明、主要商品分類、聯絡方式,每個連結附一句說明。這是我把提案套到電商的做法,提案本身沒有寫電商的範例。
改完 robots.txt,當天先打開自己的 /robots.txt,確認新內容已經上線。OpenAI 說搜尋那邊大約要 24 小時才會跟上,Perplexity 說可能要到 24 小時,所以真正的驗收放在隔天:到 CDN 或主機的紀錄裡,看你留著的爬蟲有沒有正常讀到頁面,擋掉的爬蟲裡,有自己 user agent 的那幾個還有沒有來抓;Google-Extended 本來就不會出現在紀錄裡。
資料出處
- Google Search Central:Google’s common crawlers(Google-Extended 段):https://developers.google.com/search/docs/crawling-indexing/google-common-crawlers
- Google Search Central:Optimizing your website for generative AI features on Google Search:https://developers.google.com/search/docs/fundamentals/ai-optimization-guide
- OpenAI:Overview of OpenAI Crawlers:https://platform.openai.com/docs/bots
- Anthropic:Does Anthropic crawl data from the web, and how can site owners block the crawler?(2026-04-07):https://support.claude.com/en/articles/8896518-does-anthropic-crawl-data-from-the-web-and-how-can-site-owners-block-the-crawler
- Perplexity:Perplexity Crawlers:https://docs.perplexity.ai/guides/bots
- llmstxt.org:The /llms.txt file, v2(Jeremy Howard,2024-09-03 發表,2026-08-10 更新):https://llmstxt.org/
- QDM 開店平台服務中心:2026.7.28 新增自訂 robots.txt:https://help.qdm.tw/support/solutions/articles/67000755107


